Clash规则顺序怎样读:匹配条件、首个命中与兜底项练习
以Mihomo简单域名规则和保留示例域名离线推演,区分完整域名、后缀覆盖、精确例外与MATCH兜底;交换规则次序对照结果,不更改工作配置或承诺联网。
在Clash相关客户端里加了一条精确域名规则,结果似乎仍走原来的方向,常见误会是“更具体的条件一定自动优先”。实际要看使用的内核、运行模式以及它从哪里开始匹配。本文仅用Mihomo官方文档中的简单域名规则做离线阅读练习,不提供可直接导入的完整配置,不改变任何读者的现有网络。
先核对内核与模式,别只看应用名称
“Clash”常被用来称呼不同客户端,界面和支持功能并不相同。先在自己客户端的关于或内核信息中确认是否使用Mihomo,再对应它的官方文档。若使用别的实现,需要查该实现的规则定义,不能因为某个字段看起来一样,就把本文所有边界照搬过去。
Mihomo运行模式说明区分规则、全局和直连模式。要讨论下面列表的先后判断,前提是实际使用规则模式;不能在全局或直连模式下,只凭一个网页的结果推断列表顺序。此处只是检查当前状态,不建议为了做练习切换工作中的模式,纸上推演不需要启用代理。
三种条件先读成普通语言
按当前Mihomo路由规则文档,DOMAIN比较完整域名;DOMAIN-SUFFIX比较域名后缀及其子域;MATCH无需条件,可匹配所有请求。规则自上而下比较,靠上的规则先于下面规则。本文限定为简单域名条件、DIRECT或REJECT结果的阅读练习,不涵盖子规则、PASS、UDP能力等可能继续匹配的复杂情况。
内置策略说明中,DIRECT表示直接出站,REJECT表示拒绝出站。这是处理方向,不是网页速度或服务器健康的结论。例子没有真实代理节点、订阅地址和凭据,只有用来说明关系的结果词;即使某个条件在纸上得到DIRECT,也不证明实际网页一定能打开。
先写预期,再看三条示意规则
设定一个虚构需求:拒绝docs.example.com;允许example.com及其其他子域直接出站;其余请求拒绝。这里的example系列是IANA文档示例域名,只在纸上比较,不要求访问。下列三行只是规则片段,不是完整客户端文件:
DOMAIN,docs.example.com,REJECT
DOMAIN-SUFFIX,example.com,DIRECT
MATCH,REJECT
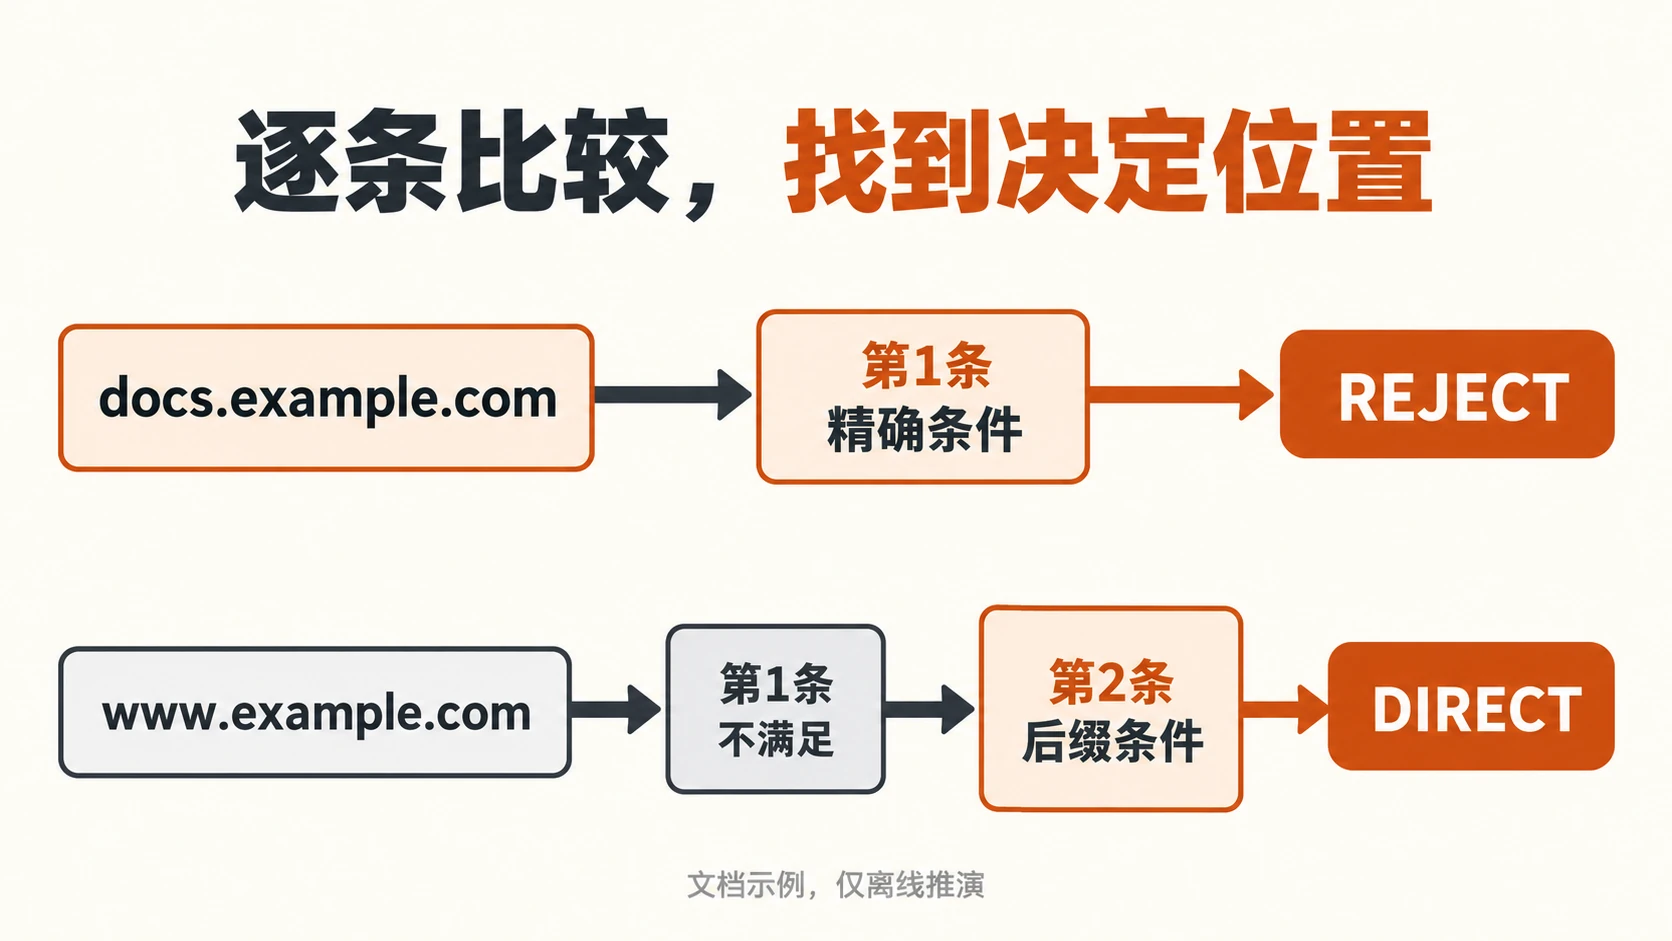
把第一行读成“如果完整域名是docs.example.com,就拒绝”。第二行读成“如果是example.com或它的子域,就直连”。第三行处理前面尚未决定的其他请求。先有需求,才能判断这个次序是否合适;不能脱离意图给所有规则列表统一排序,也不能把“具体放前面”当成无需思考的万能整理命令。
| 离线输入 | 按顺序比较 | 本例结果 |
|---|---|---|
| docs.example.com | 第一行完整域名相同 | REJECT |
| www.example.com | 第一行不同,第二行属于该后缀 | DIRECT |
| example.com | 第一行不同,第二行也包含主域本身 | DIRECT |
| example.org | 前两行均不满足,到第三行 | REJECT |
练习的通过标准不是把四行答案背下来,而是能够指出每个输入在第几行得到结果。让另一人只看需求和片段再填写这张表,若对同一输入的命中行不同,先逐条解释条件,不把分歧带到真实配置里反复试错。
把宽规则放上面,会发生什么
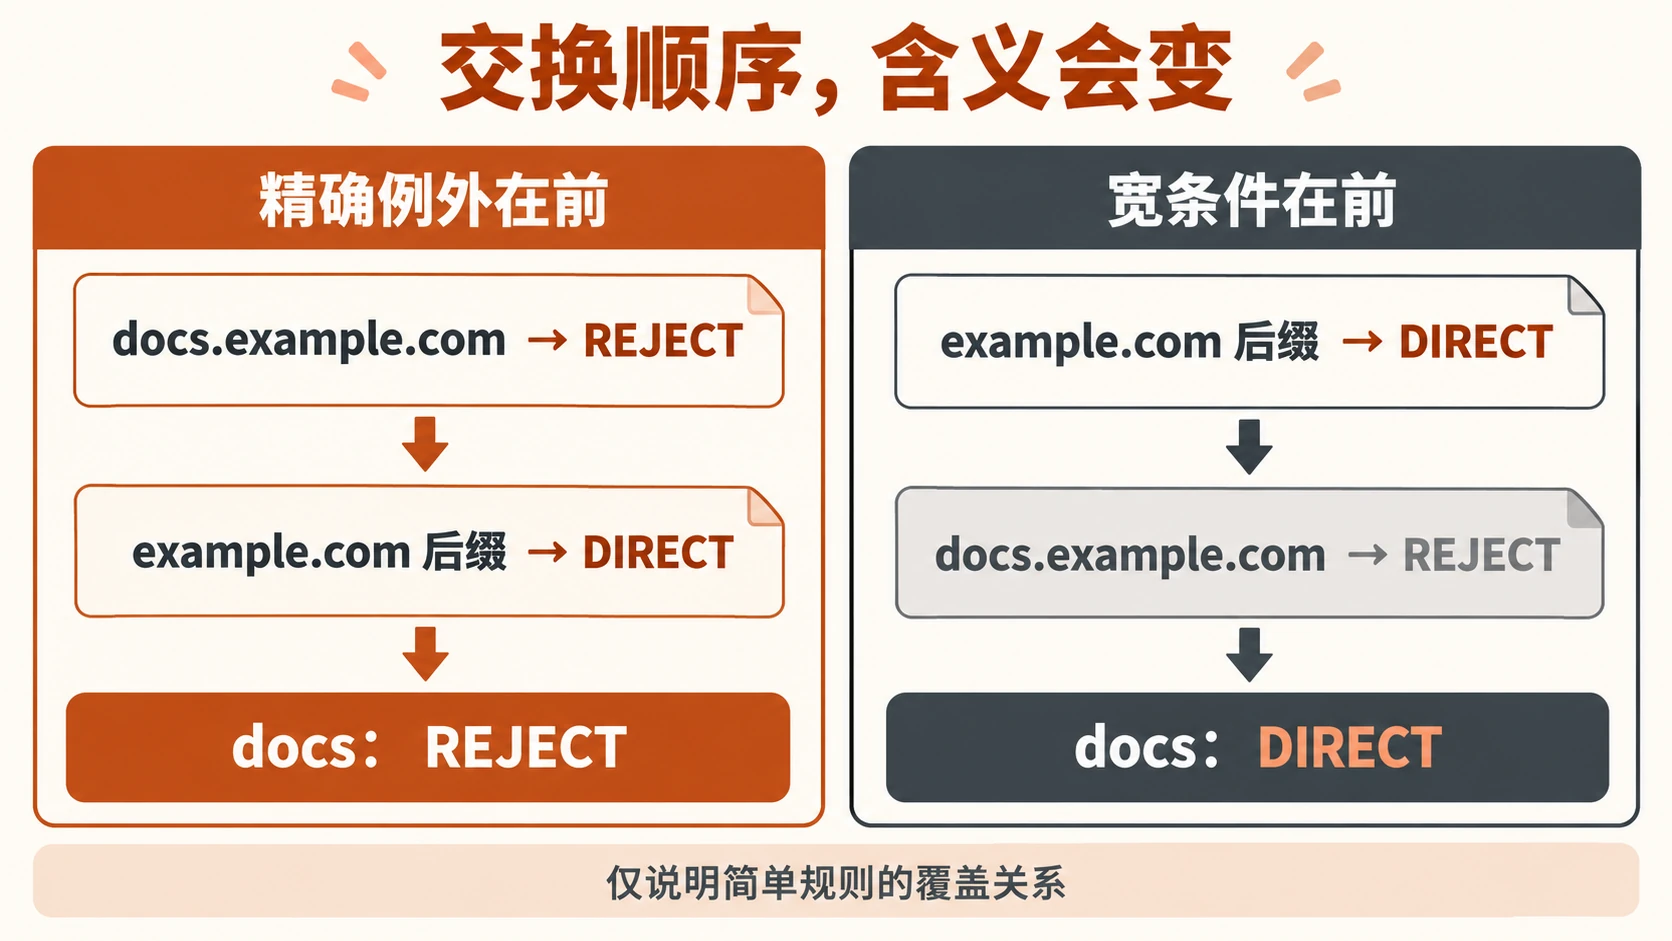
现在只在纸上交换前两行,把DOMAIN-SUFFIX,example.com,DIRECT放到最前面。docs.example.com本来也是example.com的子域,于是先满足宽条件,后面的精确拒绝在这份简单列表中没有机会决定它。结果不是程序“忘了”那条精确规则,而是先后次序已经改变了含义。
这也解释了为什么一条新增规则虽然存在,却没有实现预期。判断时要找“在它之前,是否已有条件覆盖当前对象”,而不是只搜索新增域名有没有出现在文本里。先在练习副本旁边写出覆盖关系:精确域名属于后缀集合;本次需要保留那个精确例外,所以它应先被考虑。不要因此批量调整自己所有规则,其他条目可能有不同的优先关系。
MATCH是兜底,不是万能修复按钮
若把本例的MATCH,REJECT放到第一行,所有输入都会先得到拒绝结果,后面的域名条件就失去这份练习中的意义。反过来,把兜底写成DIRECT,也会改变原本要求“其余拒绝”的需求。兜底位置与兜底结果是两件都要核对的事,不能只检查末尾有一个MATCH就认为范围正确。
可以做一个反向问题:如果你只希望某一精确域名拒绝,而其他所有请求直连,原需求与本例不同,那么最后一行应表达的范围也不同。先把需求重写清楚再推演,不能为了让一个页面打开临时改成全放行。单位管理或他人维护的规则,若不在自己权限内,应将命中判断交给维护者核对,而不是擅自覆盖。
后缀匹配要看域名层级,别只找相同文字
example.com.example.org虽然含有example.com字样,却是example.org下面的名字,不是example.com的子域。把这个输入补进上面的练习表,前两行都不应按本例条件命中,最终落到MATCH。这个反例能检查你是否把后缀匹配误读成“文本里只要包含就行”。
网址的路径也不要放进DOMAIN字段。例如页面地址中斜杠后面的help是路径,不是域名的一部分。这里只做字段含义识别,不把整个URL粘进域名条件;若需求本来需要按路径判断,应先确认正在使用的工具是否提供对应能力,不用改几个逗号就假定获得了这个功能。
给新条件准备边界输入,别只试想命中的一个名字
新增一条条件之前,可以在纸上列三组输入:应该命中的对象、与它相邻但不应该命中的对象,以及前两类之外的对象。本例应命中精确拒绝的是docs.example.com,相邻的www.example.com应留给第二条,example.org则用于检验兜底。只检查docs得到拒绝,无法发现你是否不小心把整组example.com都拒绝了。
再加入一个更深的子域a.docs.example.com。它不是与docs.example.com完全相同的名字,所以第一行DOMAIN并不覆盖它;它仍属于example.com后缀,本例会由第二行决定为DIRECT。如果真实意图是把docs下面的整个分支也拒绝,这就揭示了需求与精确条件的差别。先修正条件表达,再讨论次序;仅把第一行移动到更高位置,不能让完整域名比较自动获得覆盖全部子域的能力。
这种练习可以把错误分成两类:条件本身覆盖范围不对,以及条件正确但被更早的规则覆盖。前者要重看条件含义,后者才需要考虑前后关系。纸上记录只需保留输入、最早满足的行和预期结果三栏,每次新增一个例外就补它的相邻输入,比不断堆叠看似更精确的重复行更容易检查。
读懂片段以后,怎样回到自己的问题
先找当前实际使用的配置,而不是任意一个旧导出文件。在有权查看且软件提供记录的情况下,对照当前模式、目标域名和实际命中规则;界面不能显示命中项时,就只把纸上判断写成推演,不虚构已经观察到日志。求助材料不需要公开订阅令牌和整份配置,把相关条件前后关系保留即可。
如果文件根本无法读取,顺序分析还没有开始,可以先看本站缩进、符号和重复键的结构练习。若规则方向已经解释清楚,但连接仍异常,再借助网络连接逐层检查文章区分文本读取与请求结果;不要仅因命中某条规则就宣布DNS、服务器或浏览器都正常。
最后用三句话留下自己的理解:“本次需要保留什么例外;它前面是否有更宽条件;剩余对象由哪条兜底处理。”一份有用的阅读结果,应能让别人拿相同输入得到相同命中行,并知道这个结论只覆盖哪些简单条件。先把顺序和范围讲明白,才有依据决定是否需要由获授权的维护者作具体修改。